
深入浅出讲算法思想--减治法思想分析及应用
- 减治法解决八枚硬币问题/假币问题
- 减治法在排序算法中的应用--插入排序、快速排序
- 减治法在查找算法中的应用--折半查找、快速查找、二叉树查找
- 减治法解决约瑟夫斯问题
- 减治法在求解拓扑排序问题中的应用--有向无环图
- 减治法在生成全排列问题中的应用--回溯、Johnson-Trotter算法、字典序
- 减治法在生成子集问题中的应用--递归、二进制反射格雷码
- 减治法解决俄式乘法问题
- 减治法解决尼姆(Nim)游戏/拈游戏问题
一、八枚硬币问题
在八枚外观相同的硬币中,有一枚是假币,并且已知假币与真币的重量不同,但不知道假币与真币相比较轻还是较重。可以通过一架天平来任意比较两组硬币,设计一个高效的算法来检测出这枚假币。
我们先假设一个条件:已知假币比真币轻
**1. 二分查找算法实现:**时间复杂度(O(log(以2为底n的对数)))
思路:把n枚硬币分成两堆,每堆有枚硬币,如果n为奇数的话,就留下一枚额外的硬币,然后把两堆硬币放在天平上。如果两堆硬币重量相同,那么放在旁边的硬币就是假币;否则我们可以用同样的方式对较轻的一堆硬币进行处理,这堆硬币中一定包含那枚假币。注意,即使我们把硬币分成了两个子集,但在每次称重之后,我们只需要解决一个规模为原来一半的问题。所以这是一个减治算法而不是一个分治算法。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
public class Main {
static int[] a = {2, 2, 2, 2, 2, 2, 1, 2};
public static void main(String[] args) {
int l = 0;
int r = a.length-1;
System.out.println(f2(l, r));
}
private static int f2(int l, int r) {
int n = r - l + 1;
int mid = (l+r) / 2;
if(n == 1) {
return l;
}
/**
* n为总个数,mid为中值
* n为偶数,则将n枚硬币分成两堆数量相等的硬币,对轻的一堆迭代称重
* n为奇数,留下一枚硬币,对n-1枚硬币按偶数继续操作
* */
if (n % 2 == 0) {
if (sum(l, mid) == sum(mid+1, r)) {
return l - 1;
} else if (sum(l, mid) < sum(mid+1, r)){
return f2(l, mid);
} else {
return f2(mid+1, r);
}
} else {
return f2(l+1, r);
}
}
/**
* 获取指定区域内硬币的重量
* */
private static int sum(int l, int r) {
int sum = 0;
for (int i = l; i <= r; i++) {
sum += a[i];
}
return sum;
}
}
**2. 三分查找算法实现:**时间复杂度(O(log(以3为底n的对数))) 思路:将n枚硬币分成三组,前两组有组硬币,其余的硬币作为第三组,将前两组硬币放到天平上,如果它们的重量相同,则假币一定在第三组中,用同样的方法对第三组进行处理;如果前两组的重量不同,则假币一定在较轻的那一组中,用同样的方法对较轻的那组硬币进行处理。这也是一个减治算法。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
public class Main {
static int[] a = {2, 2, 2, 2, 2, 2, 1, 2};
public static void main(String[] args) {
int l = 0;
int r = a.length-1;
System.out.println(f3(l, r));
}
private static int f3(int l, int r) {
int n = r - l + 1;
int x;
if(n == 1) {
return l;
}
/**
* n为总个数
* 将n分成n/3, n/3, n-2(n/3)三堆硬币
* 对前两堆称重,相等则对第三堆继续操作,不相等则对轻的一堆继续操作
* */
if (n % 3 == 0) {
x = n / 3;
} else {
x = n / 3 + 1;
return f3(l+1, r);
}
int mid1 = l + x - 1;
int mid2 = mid1 + x;
if (sum(l, mid1) == sum(mid1+1, mid2)) {
return f3(mid2+1, r);
} else if (sum(l, mid1) < sum(mid1+1, mid2)){
return f3(l, mid1);
} else {
return f3(mid1+1, mid2);
}
}
/**
* 获取指定区域内硬币的重量
* */
private static int sum(int l, int r) {
int sum = 0;
for (int i = l; i <= r; i++) {
sum += a[i];
}
return sum;
}
}
二分查找算法适用于单调的一个函数,即数组序列要么升序,要么降序
而三分查找算法使用于凸函数,常用来求极值问题。
在假币问题中,三分查找在n较大的情况下,效率是优于二分查找的。
3. 最复杂的情况
下面来回到最开始的问题,在不知道假币轻重的情况下,我们通过下面的算法来实现,其时间复杂度为O(log(以2为底n的对数))
相比来说,这种情况思考起来比较复杂,但是好在逻辑清楚,只要理解了思路,算法还是好实现的,下面我们来举一个例子,假设有八枚硬币,其中有一枚硬币是假币。但是我们不知道假币是比真币重还是轻。先把八枚硬币编号,分别表示为a,b,c,d,e,f,g,h,从八枚硬币中任取六枚a,b,c,d,e,f,在天平两端各放三枚进行比较。假设a,b,c三枚放在天平的一端,d,e,f三枚放在天平的另一端,可能出现三种比较结果:
-
a+b+c>d+e+f
-
a+b+c=d+e+f
-
a+b+c<d+e+f
若a+b+c>d+e+f,可以肯定这六枚硬币中必有一枚为假币,同时也说明g、h为真币。这时可将天平两端各去掉一枚硬币,假设去掉c、f,同时将天平两端的硬币各换一枚,假设硬币b、e作了互换,然后进行第二次比较,比较的结果同样可能有三种:
-
a+e>d+b:这种情况表明天平两端去掉硬币c、f且硬币b、e互换后,天平两端的轻重关系保持不变,从而说明了假币必然是a,d中的一个,这时我们只要用一枚真币(例如h)和a进行比较,就能找出假币。若a>h,则a是较重的假币;若a=h,则d为较轻的假币;不可能出现a<h的情况。(为什么?很简单,因为我们判断了a,d中有一个假币那么e,b都是真币,则e=d。而a+e>d+b可以推出a>d,所以不管a是真是假都不可能出现a<h情况出现)
-
a+e=d+b:此时天平两端由不平衡变为平衡,表明假币一定在去掉的两枚硬币c,f中,同样用一枚真币(例如h)和c进行比较,若c>h,则c是较重的假币;若c=h,则f为较轻的假币;不可能出现c<h的情况。
-
a+e<d+b:此时表明由于两枚硬币b,e的对换,引起了两端轻重关系的改变,那么可以肯定b或e中有一枚是假币,同样用一枚真币(例如h)和b进行比较,若b>h,则b是较重的假币;若b=h,则e为较轻的假币;不可能出现b<h的情况。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
public class Main {
static int[] a = {2, 2, 2, 2, 2, 2, 1, 2};
static int flag = 0;
public static void main(String[] args) {
int p;
if (sum(0, 2) == sum(3, 5)) {
p = fp(6, 7);
} else if (sum(0, 2) > sum(3, 5)){
if (a[0] + a[4] > a[3] + a[1]) {
p = fp(0, 3);
} else if (a[0] + a[4] == a[3] + a[1]) {
p = fp(2, 5);
} else {
p = fp(1, 4);
}
} else {
if (a[0] + a[4] > a[3] + a[1]) {
p = fp(1, 4);
} else if (a[0] + a[4] == a[3] + a[1]) {
p = fp(2, 5);
} else {
p = fp(0, 3);
}
}
if (flag == 1) {
System.out.println("假币轻,为第" + p + "枚");
} else {
System.out.println("假币重,为第" + p + "枚");
}
}
private static int fp(int l, int r) {
int H, L;
int x = (l+1) % 8;
if(a[l] > a[r]) {
H = l;
L = r;
} else {
H = r;
L = l;
}
if (a[H] > a[x]) {
flag = 1;
return H;
} else {
flag = -1;
return L;
}
}
/**
* 获取指定区域内硬币的重量
* */
private static int sum(int l, int r) {
int sum = 0;
for (int i = l; i <= r; i++) {
sum += a[i];
}
return sum;
}
}
二、减治法在排序算法中的应用
**插入排序:**时间复杂度O(n^2),虽然和选择、冒泡在最坏的情况下时间复杂度相同,但是插排平均性能在比自身的最差性能快一倍,所以相比选择、冒泡来说,插排要领先于二者。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
public class Main {
public static void main(String[] args) {
int[] a = {89, 45, 68, 90, 29, 34, 17};
for (int i = 1; i < a.length; i++) {
int v = a[i];
int j = i-1;
/**
* 在前i-1个有序元素中找到一个合适位置,将a[i]插入
* */
while (j >= 0 && a[j] > v) {
a[j+1] = a[j];
j -= 1;
}
a[j+1] = v;
}
for (int i = 0; i < a.length; i++) {
System.out.print(a[i] + " ");
}
}
}
发现问题:对于有序数组这样的最优输入来说,快排的性能非常好,但是这种情况毕竟没有太大的实际意义。而当大数据量测试的时候,快排总是不尽如人意。 优化思路:基于快排的一种拓展算法----Shell(希尔)排序
三、减治法在查找算法中的应用
1. 折半查找:(时间复杂度O(log以2为底n的对数))
对于有序数组的查找来说,折半查找是一种非常高效的算法,其基本原理为:比较查找键k和数组中间元素a[m],如果相等,算法结束;如果k<a[m],对数组前半部分执行操作;如果k>a[m],对数组后半部分执行操作。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
public class Main {
static int k = 89;
static int[] a = {17, 29, 34, 45, 68, 89, 90};
public static void main(String[] args) {
int l = 0;
int r = a.length-1;
System.out.println(f(l, r));
}
private static int f(int l, int r) {
while (l <= r) {
int m = (l+r)/2;
if (k == a[m]) {
return m;
} else if (k < a[m]) {
return f(l, m-1);
} else {
return f(m+1, r);
}
}
return -1;
}
}
发现问题:对于依赖键值操作的查找算法来说,折半查找已经是最优的查找算法了,但是还是有些算法具有更优良的平均效率 解决思路:插值查找,散列查找(散列法甚至不需要输入数组是有序的)
插值查找:不同于折半查找总是把查找值和给定有序数组的中间元素比较(将问题规模削减一半),差值查找更像是在字典中查字的形式,如果我们找“班”这个字,那么我们一定先找“B”字母的区域,我们不会去从字典中间区域开始。准确来说,插值查找同样采用比较的方式,但是它考虑了查找键的值。
实际上对于较小数据的查找,折半会更好;而对于大数据量而言,插值查找则更值得考虑。
**2. 快速查找:**选择问题是求一个n个数列表的第k个最小元素的问题,这个数k被称为顺序统计量。对于k=1或k=n来说,这并没有什么意义,我们通常会要找出这样的元素:该元素比列表中一半元素大,比另一半元素小,这样的元素被称为中值。我们当然可以对列表进行排序,之后找出对应下标的值,但是!!!这样一个查找问题,反而要对整个列表排序,是不是有点多余了呢?
这里引入划分的概念我们可以标定一个枢轴(任意元素,一般为首个元素),使得左半部分元素均小于枢轴,右半部分均大于枢轴。划分的方法由两种,Lomuto划分和Hoare划分。这里仅介绍Lomuto。
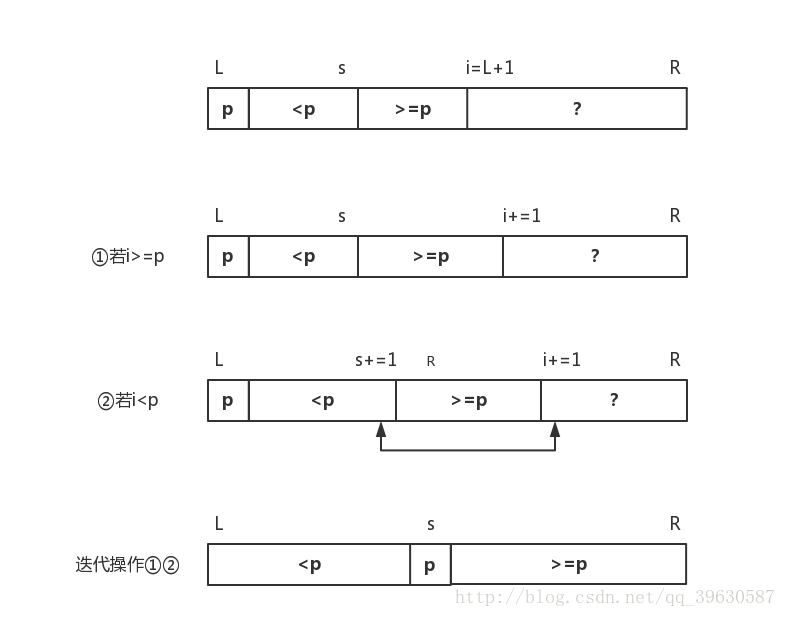
我们假设有一个数组a[0, n-1],其子数组为a[l, r](0 <= l <= r <= n-1),假定首个元素为枢轴p,将该数组分为三段,顺序放在p之后,依次为,第一段[元素小于p],第二段[元素大于等于p],第三段[尚未处理元素]。算法开始时前两段均为空。
从i = l+1开始,从左到右扫描子数组a[l, r],将第三段的首个元素与p比较,若a[i]>=p,执行i+1,这就相当于将a[i]划入了第二段,同时缩小了第三段;若a[i]<p,需要将s+1(s始终指向第一段的末位元素),同时交换a[i]与a[s],之后i+1。直到第三段为空,交换a[p]与a[s]。
下图为Lomuto划分示意图:
 熟悉快速排序的读者估计看出来了,这就是快速排序中的一部分函数,只不过没有接触过Lomuto这种叫法而已。
当然,我们这里使用的方法就是快速选择(“快速”这一方法一开始并非用于排序,而是查找),下面给出查找第k小元素的代码:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
public class Main {
static int[] a= {89, 45, 68, 90, 29, 34, 17};
static int k = 2;
public static void main(String[] args) {
System.out.println(fastsort(0, a.length-1, k));
for (int i = 0; i < a.length; i++) {
System.out.print(a[i] + " ");
}
}
private static int Lomuto(int l, int r) {
int p = a[l];
int s = l;
for (int i = l+1; i <= r; i++) {
if (a[i] < p) {
s = s+1;
int temp = a[s];
a[s] = a[i];
a[i] = temp;
}
}
int temp = a[l];
a[l] = a[s];
a[s] = temp;
return s;
}
private static int fastsort(int l, int r, int k) {
int s = Lomuto(l, r);
/**
* s在划分之后变成了枢轴所在的位置下标,如果s=k,输出a[s]
* 这里要写成l+k-1,如果划分到右侧,只写k会出问题
* */
if (s == l + k - 1) {
return a[s];
}else if (s > l + k - 1){
return fastsort(l, s-1, k);
} else {
return fastsort(s+1, r, l+k-1-s);
}
}
}
不幸的是,这样的算法时间复杂度为O(n^2),比之前基于排序的方法实际上更糟糕,但是分析表明,这种方法的平均情况下效率是线性的。而且基于划分的算法不仅可以查找第k小的元素,还可以给出列表中k个最小元素和n-k个最大元素。
3. 二叉查找树的查找与插入:
二叉排序树或者是一棵空树,或者是具有下列性质的二叉树:
- 若左子树不空,则左子树上所有结点的值均小于或等于它的根节点的值;
- 若右子树不空,则右子树上所有结点的值均大于或等于它的根结点的值;
- 左、右子树也分别为二叉排序树。
对于二叉查找树这里我们介绍查找、插入和删除操作:
这些操作会将问题的规模变成一个更小的二叉树,也运用到了减治法的思想。
查找思路:如果树为空,直接返回,查找失败。反之,将查找值key与根root的值比较,如果相等,则root即为所找;若key < root.v,则继续在左子树查找;若key >root.v,则继续在右子树查找。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
public static Node find(int key) {
if (root == null) {
System.out.println("The tree is empty!");
return null;
}
Node cur = root;
while (cur.v != key) {
if (key < cur.v) {
cur = cur.l;
}
else {
cur = cur.r;
}
if (cur == null) {
return null;
}
}
return cur;
插入思路:基本思想和查找操作类似,如果为空树,直接返回,插入节点即为根节点;否则,比较根节点的值与插入节点的值。注意用parent记录遍历到最后的cur值。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18public static Node find(int key) {
if (root == null) {
System.out.println("The tree is empty!");
return null;
}
Node cur = root;
while (cur.v != key) {
if (key < cur.v) {
cur = cur.l;
}else {
cur = cur.r;
}
if (cur == null) {
return null;
}
}
return cur;
}
删除思路:删除操作是二叉树操作中最复杂的问题。对于二叉树的删除有一下三种情况:
-
删除叶子结点。可直接删除,不会影响其他
-
删除结点有且只有一侧孩子结点。孩子结点覆盖待删除结点,删除孩子结点
-
删除结点下既有左孩子,又有右孩子。在待删除结点的右孩子下,找到v值最小的,用这个结点覆盖要删除的结点。(这里是因为中序遍历结点的后继结点一定是在右子树中v值最小的结点)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79public static boolean delete(int key) {
Node cur = root;
Node parent = root;
boolean hasLeft = true;
while (cur != null && cur.v != key) {
parent = cur;
if (key < cur.v) {
cur = cur.l;
hasLeft = true;
} else {
cur = cur.r;
hasLeft = false;
}
}
if (cur == null) {
return false;
}
if (cur.l == null && cur.r == null) {
/**
* 要删除的节点为叶子节点,直接删除
* */
if (cur == root) {
root = null;
}
if (hasLeft) {
parent.l = null;
} else {
parent.r = null;
}
} else if (cur.r == null) {
/**
* 要删除的节点只有左孩子
* */
if (cur == root) {
root = cur.l;
}
if (hasLeft) {
parent.l = cur.l;
} else {
parent.r = cur.l;
}
} else if (cur.l == null) {
/**
* 要删除的节点只有右孩子
* */
if (cur == root) {
root = cur.r;
}
if (hasLeft) {
parent.l = cur.r;
}else {
parent.r = cur.r;
}
} else {
/**
* 要删除的节点既有左孩子又有右孩子
* 思路:用待删除节点右子树中的v值最小的结点来替代要删除的节点,然后删除右子树中结点
* 右子树中v值最小的节点一定没有左子树,所以删除的这个结点一定是属于叶子节点或只有右子树的节点
* */
Node directPostNode = getPost(cur);
cur.v = directPostNode.v;
}
return true;
}
private static Node getPost(Node delNode) {
Node parent = delNode;
Node dir = delNode;
Node cur = delNode.r;
while (cur != null) {
parent = dir;
dir = cur;
cur = cur.l;
}
if (dir != delNode.r) {//从树中删除此直接后继节点
parent.l = dir.r;
dir.r = null;
}
return dir;
}
完整代码如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171class Node {
int v;
Node l;
Node r;
public Node(int v) {
this.v = v;
}
}
public class Main {
public static Node root;
public static Node find(int key) {
    if (root == null) {
        System.out.println("The tree is empty!");
        return null;
    }
    Node cur = root;
    while (cur.v != key) {
        if (key < cur.v) {
            cur = cur.l;
        }
        else {
            cur = cur.r;
        }
        if (cur == null) {
            return null;
        }
    }
    return cur;
}
public static void insert(Node node) {
if (root == null) {
root = node;
return;
}
Node cur = root;
Node parent = root;
boolean hasLeft = true;
while (cur != null) {
parent = cur;
if (node.v > cur.v) {
cur = cur.r;
hasLeft = true;
} else {
cur = cur.l;
hasLeft = false;
}
}
if (hasLeft) {
parent.l = node;
} else {
parent.r = node;
}
}
public static boolean delete(int key) {
Node cur = root;
Node parent = root;
boolean hasLeft = true;
while (cur != null && cur.v != key) {
parent = cur;
if (key < cur.v) {
cur = cur.l;
hasLeft = true;
} else {
cur = cur.r;
hasLeft = false;
}
}
if (cur == null) {
return false;
}
if (cur.l == null && cur.r == null) {
/**
* 要删除的节点为叶子节点,直接删除
* */
if (cur == root) {
root = null;
}
if (hasLeft) {
parent.l = null;
} else {
parent.r = null;
}
} else if (cur.r == null) {
/**
* 要删除的节点只有左孩子
* */
if (cur == root) {
root = cur.l;
}
if (hasLeft) {
parent.l = cur.l;
} else {
parent.r = cur.l;
}
} else if (cur.l == null) {
/**
* 要删除的节点只有右孩子
* */
if (cur == root) {
root = cur.r;
}
if (hasLeft) {
parent.l = cur.r;
}else {
parent.r = cur.r;
}
} else {
/**
* 要删除的节点既有左孩子又有右孩子
* 思路:用待删除节点右子树中的v值最小的结点来替代要删除的节点,然后删除右子树中结点
* 右子树中v值最小的节点一定没有左子树,所以删除的这个结点一定是属于叶子节点或只有右子树的节点
* */
Node directPostNode = getPost(cur);
cur.v = directPostNode.v;
}
return true;
}
private static Node getPost(Node delNode) {
Node parent = delNode;
Node dir = delNode;
Node cur = delNode.r;
while (cur != null) {
parent = dir;
dir = cur;
cur = cur.l;
}
if (dir != delNode.r) {//从树中删除此直接后继节点
parent.l = dir.r;
dir.r = null;
}
return dir;
}
public static void preorder(Node node) {
System.out.print(node.v + " ");
if (node.l != null)
preorder(node.l);
if (node.r != null)
preorder(node.r);
}
public static void main(String[] args) {
/**
* 插入
* */
insert(new Node(20));
insert(new Node(10));
insert(new Node(30));
/**
* 查找
* */
System.out.println(find(20));
/**
* 删除
* */
delete(20);
/**
* 前序遍历
* */
preorder(root);
}
}
四、减治法在查找算法中的应用
问题背景:据说著名犹太历史学家 Josephus有过以下的故事:在罗马人占领乔塔帕特后,39 个犹太人与Josephus及他的朋友躲到一个洞中,39个犹太人决定宁愿死也不要被敌人抓到,于是决定了一个自杀方式,41个人排成一个圆圈,由第1个人开始报数,每报数到第3人该人就必须自杀,然后再由下一个重新报数,直到所有人都自杀身亡为止。然而Josephus 和他的朋友并不想遵从。首先从一个人开始,越过k-2个人(因为第一个人已经被越过),并杀掉第k个人。接着,再越过k-1个人,并杀掉第k个人。这个过程沿着圆圈一直进行,直到最终只剩下一个人留下,这个人就可以继续活着。问题是,给定了和,一开始要站在什么地方才能避免被处决?Josephus要他的朋友先假装遵从,他将朋友与自己安排在第16个与第31个位置,于是逃过了这场死亡游戏。
简化约瑟夫斯问题:n个人围成一圈,从第一个开始报数,第m个将被杀掉,最后剩下一个,其余人都将被杀掉。例如n=6,m=5,被杀掉的顺序是:5,4,6,2,3,1。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38import java.util.ArrayList;
import java.util.List;
import java.util.Scanner;
public class Main {
public static void main(String[] args) {
Scanner scanner = new Scanner(System.in);
System.out.print("请输入总人数:");
int n = scanner.nextInt();
System.out.print("第几个将被杀死:");
int m = scanner.nextInt();
yuesefu(n, m);
}
public static void yuesefu(int n, int m) {
// 初始化人数
List<Integer> list = new ArrayList<>();
for (int i = 1; i <= n; i++) {
list.add(i);
}
//从第K个开始计数
int k = 0;
while (list.size() >0) {
k = k + m;
//第m人的索引位置
k = k % (list.size()) - 1;
// 判断是否到队尾
if (k < 0) {
System.out.println(list.get(list.size()-1));
list.remove(list.size() - 1);
k = 0;
} else {
System.out.println(list.get(k));
list.remove(k);
}
}
}
}
当然约瑟夫斯问题也有数学公式,可以直接得到最后一个存活的人,因为不涉及减治思想,在这里就不详细讲解了。
五、减治法在求解拓扑排序问题中的应用
**拓扑排序:**对于一个有向无环图来说,如果我们能够按照次序列出顶点,使得对于每条边来说,边的起始顶点总是排在边的结束顶点之前,那么这个过程就称为拓扑排序,拓扑排序有解是一个图是有向无环图的充要条件。基于减治法的拓扑排序,基本原理是源删除,每次寻找一个入度为0的点,根据这个点的出度找到下一个点,然后删除这个点和所有的所有出度,再继续迭代操作。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61public class Main {
public static void main(String[] args) {
int[][] e = {{0, 0, 1, 0, 0},
{0, 0, 1, 0, 0},
{0, 0, 0, 1, 1},
{0, 0, 0, 0, 1},
{0, 0, 0, 0, 0},};
char[] result = f(e);
for(int i = 0;i < result.length;i++)
System.out.print(result[i]+" ");
}
public static char[] f(int[][] e){
int[] source = get(e);
char[] result = new char[source.length];
int cnt = 0;
int flag = 1;
while(flag == 1){
for(int i = 0;i < source.length;i++){
/**
* 寻找入度为0的点,进入排序队列,入度值设为-1
* */
if(source[i] == 0) {
result[cnt++] = (char) ('a'+i);
source[i] = -1;
for(int j = 0;j < e[i].length;j++) {
if(e[i][j] == 1) {
source[j] -= 1; //第j个顶点的入度减1
}
}
}
}
if(cnt == source.length)
flag = 0;
}
return result;
}
/**
* 返回给出图每个顶点的入度值
*/
public static int[] get(int[][] e){
int len = e[0].length;
int[] source = new int[len];
for(int i = 0;i < len;i++){
int count = 0;
for(int j = 0;j < len;j++){
/**
* 列对应入读
* */
if(e[j][i] == 1)
count++;
}
source[i] = count;
}
return source;
}
}
发现问题:拓扑排序的解通常不止一个,如果是数据量庞大的工程,那么在进行算法之前一定要检查集合是否满足有向无环图,而且大数据量的情况下这种基于减治的算法和基于搜索算法DFS效率都是不高的。 优化思路:CPM(关键路径法)和PERT(程序评估和检查技术)
六、减治法在生成全排列中的应用(JAVA)--回溯、Johnson-Trotter算法、字典序
在深入浅出讲算法思想--蛮力法思想分析及应用这篇文章的最优解问题中中已经初步讲解了这类应用,下面我们将使用减治法再次思考这类问题。
全排列问题,在数学中求解一个n个数组的全排列问题会产生n!个组合的情况。暴力枚举的确是个方法,但是除非n非常的小,不然这个时间复杂度是非常庞大的,但是如果运用减治思想就可以解决这种问题,我们便可以将我们可以将生成n!个排雷的问题变为求解(n-1)!个全排列的问题,之后再将n插入n-1个元素每种排列中n可能的位置中去。因为n*(n-1)!=n!,所以这就是该算法的可行性分析。
1. 简单回溯实现:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28public class Main {
static int[] a = new int[4];
static int[] visit = new int[4];
public static void main(String[] args) {
int n = 3;
f(0, n);
}
private static void f(int cur, int n) {
if (cur == n) {
for (int i = 0; i < n; i++) {
if ((i+1) % 3 == 0) {
System.out.print(a[i] + " ");
System.out.println();
} else {
System.out.print(a[i] + " ");
}
}
}
for (int i = 1; i <= n; i++) {
if (visit[i] == 0) {
visit[i] = 1;
a[cur] = i;
f(cur+1, n);
visit[i] = 0;
}
}
}
}
**2. Johnson-Trotter算法实现:**参考johnson_trotter(生成排列算法) **3. 字典序实现:**第二种算法实现的结果输出是从最后一个开始的,不过,按照习惯上的写法,我们总是希望结果是按照升序排列的,而字典序可以实现这种即高效又是升序的效果。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81public class Main {
public static void main(String[] args) {
int arr[] = new int[]{1,2,3};
sort(arr);
for (int i = 0; i < arr.length; i++) {
System.out.print(arr[i]);
}
System.out.println();
while(nextPermutation(arr))
{
for(int value : arr)
System.out.print(value);
System.out.println();
}
}
public static boolean nextPermutation(int[] arr)
{
int pos1 = 0;
int pos2 = 0;
/**
* 找到使得a[i] < a[i+1]的最大的i,赋给pos1
* 用于将123变为132这样的情况
* */
int flag = 0;
for(int i = arr.length - 2;i >= 0;i--) {
if(arr[i] < arr[i + 1]) {
pos1 = i;
flag = 1;
break;
}
}
if(flag == 0) {
return false;
}
/**
* 找到使得a[i]<a[j]的最大的j,赋给pos2
* 用于362541变为364125这样的情况
* */
for(int j = pos1 + 1;j < arr.length;j++) {
if(arr[j] > arr[pos1]) {
pos2 = j;
}
}
/**
* 交换a[pos1]与a[pos2]
* */
int temp = arr[pos1];
arr[pos1] = arr[pos2];
arr[pos2] = temp;
/**
* 对a[i+1]到a[n]逆序
* */
for (int i = pos1+1; i < arr.length; i++) {
for (int j = arr.length-1; j > i ; j--) {
temp = arr[i];
arr[i] = arr[j];
arr[j] = temp;
}
}
return true;
}
/**
* 冒泡
* */
public static void sort(int[] arr) {
for(int i = 0;i < arr.length - 2;i++) {
for(int j = 0;j < arr.length - i - 1;j++) {
if(arr[j] > arr[j + 1]) {
int temp = arr[j];
arr[j] = arr[j + 1];
arr[j + 1] = temp;
}
}
}
}
}
七、减治法在生成子集问题中的应用--递归、二进制反射格雷码
生成子集问题:经典的背包问题就是求解一个最优子集的问题,这里我们来讨论一个更简单的问题。对于任意一个集合来说,它都存在2^n个子集(一个集合所有的子集集合称为幂集)。
1. 简单递归实现:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
import java.util.ArrayList;
import java.util.List;
public class Main {
public static void main(String[] args) {
List<Integer> list = new ArrayList<>();
list.add(1);
list.add(2);
list.add(3);
List<Integer> li = new ArrayList<>();
f(0, list, li);
}
public static void f(int i, List list, List li) {
if (i > (list.size() - 1)) {
System.out.println(li);
} else {
li.add(list.get(i));// 左加
f(i + 1, list, li);
li.remove(list.get(i)); // 右去
f(i + 1, list, li);
}
}
}
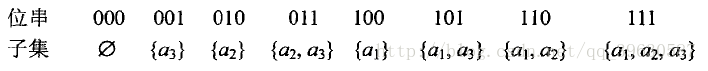 上面这个算法简单实用,但是习惯上来说,我们更喜欢严格的升序排列,而不是这种混乱的情况。这里引入挤压序的概念,集合内按字典序顺序排列,集合与集合之间,按照元素个数严格增加一种序列。
**2. 二进制反射格雷码:**这种算法得到的序列不仅是挤压序,而且还是一种最小变化法。下面的算法是使用了数学公式实现的,所以代码量很少,既然有数学公式,何乐而不为呢?难道要像NP问题一样没有公式才好吗?算法的“投机取巧”也在能直接利用数学公式上。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
import java.util.Scanner;
public class Main {
public void getGrayCode(int bitNum){
for(int i = 0; i < (int)Math.pow(2, bitNum); i++){
int grayCode = (i >> 1) ^ i;
System.out.println(numBinary(grayCode, bitNum));
}
}
public String numBinary(int num, int bitNum){
String ret = "";
for(int i = bitNum-1; i >= 0; i--){
ret += (num >> i) & 1;
}
return ret;
}
public static void main(String[] args) {
Main test = new Main();
Scanner in = new Scanner(System.in);
int n = in.nextInt();
test.getGrayCode(n);
}
}
八、减治法解决俄式乘法问题
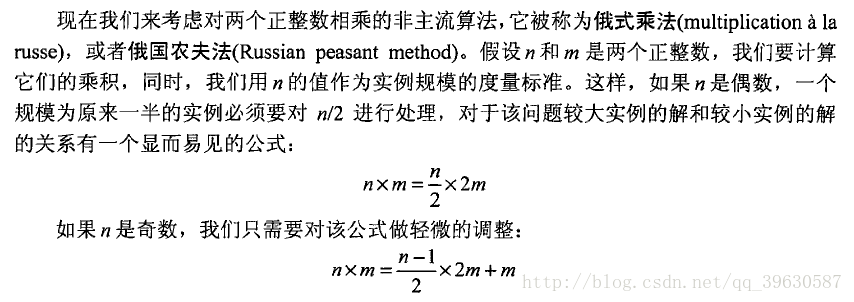 以上是在《算法设计与分析基础》一书中给出的定义。
这种算法只包括折半、加倍、相加这几个操作,在计算时,不需要用九九乘法表 。
同时,这个方法每次都会讲计算的规模减少,运用了减治的思想
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
public class Main {
public static void main(String[] args) {
int result = RusseMul(24,32);
System.out.println(result);
}
public static int RusseMul(int n,int m){
int result = m;
if(n == 1) {
return result;
}
else {
if(n % 2 == 0) {
result = RusseMul(n/2,2*m);
}
else {
result = RusseMul((n-1)/2,2*m) + m;
}
}
return result;
}
}
九、减治法解决尼姆(Nim)游戏/拈游戏问题
尼姆游戏是一种两个人玩的回合制数学策略游戏。游戏者轮流从一堆棋子(一共有好几堆,一次只能从其中一堆拿。)(或者任何道具)中取走一个或者多个,最后不能再取的就是输家。当指定相应数量时,一堆这样的棋子称作一个尼姆堆。
尼姆游戏有很多形式,也可以说很多游戏的原型都是尼姆游戏。
单堆尼姆游戏:
假设我们现在有一堆n枚棋子,两个玩家轮流从堆中拿走至少1枚,至多m枚棋子。每次拿走的棋子数都可以不同,但能够拿走的上下限数量是不变的。如果每个玩家都做出了最佳选择,哪个玩家能够拿到最后一枚棋子?是先走的还是后走的?
我们认为n=0是一个败局,因为接下来要走的人是第一个无路可走的人。
-
任何1 <= s <= m(s为堆中剩余棋子)的局面都是胜局,因为玩家A总能取走所有棋子,同时得到最后一枚棋子
-
s = m + 1的局面是一个败局,因为无论玩家A取走几枚棋子,总能把对方推向胜局,即第一种情况。
-
那么任意 1 + (m+1) <= s <= m +(m+1)都是一个胜局,因为无论玩家A怎么走,都会给对面一个必输的局面。
根据数学归纳法,当且仅当n不是m+1的倍数时,n个棋子的实例是一个胜局,胜利的策略是每次拿走n mod (m+1)个棋子,如果背离这个策略,则会将胜局留给对手。
总结:如果棋子数量n为m+1的倍数,那么先手的人是一个败局,否则先手的人是一个胜局,当然前提是双方都知道最优策略。
import java.util.Scanner;
public class Main { public static void main(String[] args) { Scanner in = new Scanner(System.in); int n = in.nextInt(); int m = in.nextInt(); if (n % (m+1) == 0) { System.out.println("后手赢"); } else { System.out.println("先手赢"); } } } 当然除了单堆尼姆游戏,还有多对尼姆游戏,巧妙的是,对于多堆尼姆游戏的解来说,它基于堆中棋子数的二进制表示。、 多堆尼姆游戏:
假设我们现在有数目分别为3、 4、 5的三堆棋子,两个玩家轮流从其中拿走至少1枚,至多为一整堆的棋子数。每次拿走的棋子数都可以不同,但能够拿走的下限数量是不变的。如果每个玩家都做出了最佳选择,哪个玩家能够拿到最后一枚棋子?是先走的还是后走的?
我们需要求出每堆棋子数的二进制数位和(也叫Nim和),即对每一位分别求和并忽略进制。
实际上,当Nim和中包含至少一个1时,该实例为一个胜局;相应的,当Nim和中只包含0时,该实例为一个败局
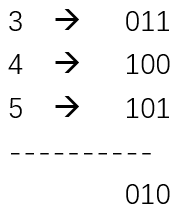
所以对于先走的玩家来说,这是一个胜局,走法为改变三个位串中的一个,使Nim和仅包含0,例如从第一个堆中拿走2个。