
图论算法(四)--最小生成树的Kruskal[加边]、Prim[加点]的解法(JAVA)
之前我们介绍了求最短路径算法,现在又讲最小生成树算法,这两个算法有什么区别呢?
首先要明确,最短路径和最小生成树是两个不同的概念。 最短路径是对于一个图的两个结点而言的。在一个图中,结点A通过某些结点和边可以走到结点B,这些结点和边组成的从A到B的路径中,最短路径就这些路径中权值总和最小的那一条(或多条)。 最短路径常用算法有:Floyd、Dijkstra、SPFA、**A***等
最小生成树是对于一个图本身而言的。对于一个有n个结点的无向连通图,必然可以去掉某些边,使得最终剩下n-1条边,与n个结点共同组成原图的一个生成树,而最小生成树就是所有可能的生成树中n-1条边的权值总和最小的那一个(或多个)。 常用算法有:Kruskal、Prim
我们现在在1号位置,我们要走遍图中的所有顶点,各条路上的数值即为权值,求这个过程中的最小权值是多少?
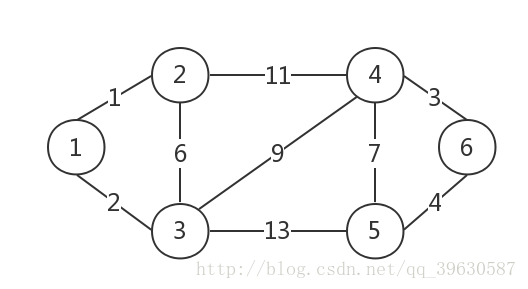
Input: 6 9 2 4 11 3 5 13 4 6 3 5 6 4 2 3 6 4 5 7 1 2 1 3 4 9 1 3 2 Output: 19
Kruskal
又称 “加边法”
适用于稀疏图
时间复杂度:O(MlogN),但通常边M的数目要比顶点N的数目多很多,所以最终时间复杂度为O(MlogM)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
import java.util.Scanner;
class edge {
int u, v, w;
edge(int u, int v, int w) {
this.u = u;
this.v = v;
this.w = w;
}
}
public class Kruskal {
static edge[] e = new edge[10];
static int n, m;
static int[] f = new int[7];
static int sum = 0;
static int count = 0;
static Scanner input = new Scanner(System.in);
public static void main(String[] args) {
n = input.nextInt();
m = input.nextInt();
for (int i = 1; i <= m; i++) {
int a = input.nextInt();
int b = input.nextInt();
int c = input.nextInt();
e[i] = new edge(a, b, c);
}
/**
* 按权值排序
* */
quicksort(e, 1, m);
for (int i = 1; i <= n; i++) {
f[i] = i;
}
kruskal();
System.out.println(sum);
}
private static void kruskal() {
/**
* 从小到大枚举每一条边
* */
for (int i = 1; i <= m; i++) {
/**
* 检查一条边的两个顶点是否已经连通,即判断是否在同一个集合中
* */
if (merge(e[i].u, e[i].v)) {
count++;
sum = sum + e[i].w;
}
/**
* 选到n-1边之后,退出循环
* */
if (count == n - 1) {
break;
}
}
}
public static int partition(edge[] a, int p, int q) {
int x = a[p].w;
int i = p;
for (int j = p+1; j <= q; j++) {
if (a[j].w <= x) {
i += 1;
edge temp = a[i];
a[i] = a[j];
a[j] = temp;
}
}
edge temp = a[p];
a[p] = a[i];
a[i] = temp;
return i;
}
public static void quicksort(edge[] a,int p, int q) {
if (p < q) {
int r = partition(a ,p ,q);
quicksort(a, p, r - 1);
quicksort(a, r + 1, q);
}
}
private static int getf(int v) {
if (f[v] == v) {
return v;
} else {
/**
* 压缩路径,每次函数返回时,将该位置的编号转成祖宗编号
* */
f[v] = getf(f[v]);
return f[v];
}
}
private static boolean merge(int v, int u) {
int t1 = getf(v);
int t2 = getf(u);
/**
* 判断祖先是否相同
* */
if (t1 != t2) {
/**
* 靠左原则
* */
f[t2] = t1;
return true;
}
return false;
}
}
prim
又称 “加点法”
适用于稠密图
时间复杂度:O(N^2)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
import java.util.Scanner;
public class prim {
static int[][] e = new int[7][7];
static int[] book = new int[7];
static int[] dis = new int[7];
static int count = 0;
static int sum = 0;
static int n, m;
static int min, mark;
static Scanner input = new Scanner(System.in);
public static void main(String[] args) {
n = input.nextInt();
m = input.nextInt();
for (int i = 1; i <= n; i++) {
for (int j = 1; j <= n; j++) {
if (i == j) {
e[i][j] = 0;
} else {
e[i][j] = 99999999;
}
}
}
for (int i = 1; i <= m; i++) {
int a = input.nextInt();
int b = input.nextInt();
int c = input.nextInt();
e[a][b] = c;
e[b][a] = c;
}
for (int i = 1; i <= n; i++) {
dis[i] = e[1][i];
}
book[1] = 1;
prime();
System.out.println(sum);
}
private static void prime() {
count++;
while (count < n) {
min = 99999999;
for (int i = 1; i <= n; i++) {
if(book[i] == 0 && dis[i] < min) {
min = dis[i];
mark = i;
}
}
book[mark] = 1;
count++;
sum += dis[mark];
for (int i = 1; i <= n; i++) {
if (book[i] == 0 && dis[i] > e[mark][i]) {
dis[i] = e[mark][i];
}
}
}
}
}
而如果借助“堆”,每次选边的时间复杂度可以变为O(logM)
方法:
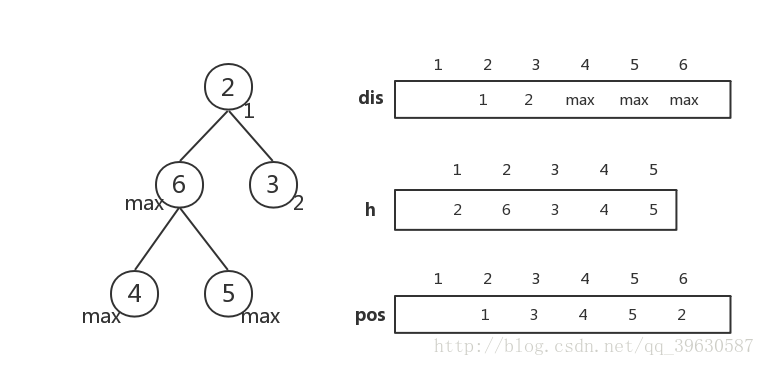
数组dis用来记录生成树到各个顶点的距离。
数组h是一个最小堆,堆里面存储的是顶点的编号。这里不是按照顶点编号的大小创建的,而是按照顶点在数组dis中对应的值建立这个最小堆。
数组pos用来记录每个顶点的最小堆的位置
下面的左图代表,
1号结点到2号点的距离为1
1号结点到3号点的距离为2
1号结点到6号点的距离为max
1号结点到4号点的距离为max
1号结点到5号点的距离为max
下面的右图代表
dis数组存放了左图的信息
h数组存放堆
poa数组存放了顶点对应在堆中的位置
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
import java.util.Scanner;
public class prim2 {
static int[] book = new int[7];
static int[] dis = new int[7];
static int[] h = new int[7];
static int[] pos = new int[7];
static int[] u = new int[19];
static int[] v = new int[19];
static int[] w = new int[19];
static int[] first = new int[7];
static int[] next = new int[19];
static int count = 0, size;
static int sum = 0;
static int n, m;
static int min, mark, mark2;
static Scanner input = new Scanner(System.in);
public static void main(String[] args) {
n = input.nextInt();
m = input.nextInt();
for (int i = 1; i <= m; i++) {
u[i] = input.nextInt();
v[i] = input.nextInt();
w[i] = input.nextInt();
}
/**
* 无向图需要再将所有边反向存储一次
* */
for (int i = m + 1; i <= 2 * m; i++) {
u[i] = v[i - m];
v[i] = u[i - m];
w[i] = w[i - m];
}
/**
* 邻接表
* */
for (int i = 1; i <= n; i++) {
first[i] = -1;
}
for (int i = 1; i <= 2 * m; i++) {
next[i] = first[u[i]];
first[u[i]] = i;
}
prime();
System.out.println(sum);
}
private static void prime() {
book[1] = 1;
count++;
dis[1] = 0;
/**
* 初始化dis数组,存放1到其他各点的距离
* */
for (int i = 2; i <= n; i++) {
dis[i] = 99999999;
}
mark2 = first[1];
while (mark2 != -1) {
dis[v[mark2]] = w[mark2];
mark2 = next[mark2];
}
/**
* 初始化堆
* */
size = n;
for (int i = 1; i <= size; i++) {
h[i] = i;
pos[i] = i;
}
for (int i = size / 2; i >= 1; i--) {
siftdown(i);
}
/**
* 直接弹出堆顶元素
* */
pop();
while (count < n) {
mark = pop();
book[mark] = 1;
count++;
sum += dis[mark];
/**
* 扫描mark的所有边,以j为中间节点,进行松弛
* */
mark2 = first[mark];
while (mark2 != -1) {
if (book[v[mark2]] == 0 && dis[v[mark2]] > w[mark2]) {
dis[v[mark2]] = w[mark2];
/**
* 对该点在堆中进行向上调整,pos[v[k]]是订点v[k]在堆中的位置
* */
siftup(pos[v[mark2]]);
}
mark2 = next[mark2];
}
}
}
private static void siftup(int i) {
int flag = 0;
/**
* 堆顶
* */
if (i == 1) {
return;
}
while (i != 1 && flag == 0) {
/**
* 当前节点是否小于父结点
* */
if (dis[h[i]] < dis[h[i/2]]) {
swap(i, i/2);
} else {
flag = 1;
}
/**
* 向上调整
* */
i = i/2;
}
}
private static void swap(int x, int y) {
int temp = h[x];
h[x] = h[y];
h[y] = temp;
temp = pos[h[x]];
pos[h[x]] = pos[h[y]];
pos[h[y]] = temp;
}
private static void siftdown(int i) {
int t, flag = 0;
while (i * 2 <= size && flag == 0) {
if (dis[h[i]] > dis[h[i*2]]) {
t = i * 2;
} else {
t = i;
}
if (i * 2 + 1 <= size) {
if (dis[h[t]] > dis[h[i * 2 + 1]]) {
t = i * 2 + 1;
}
}
if (t != i) {
swap(t, i);
i = t;
} else {
flag = 1;
}
}
}
private static int pop() {
/**
* 记录栈顶元素
* */
int t = h[1];
pos[t] = 0;
/**
* 将堆底元素赋到堆顶
* */
h[1] = h[size];
pos[h[1]] = 1;
/**
* 栈元素数目减 1
* */
size--;
siftdown(1);
return t;
}
}