
深入浅出讲算法思想--贪婪法思想分析及应用
贪婪算法:
通过一系列步骤来构造问题的解,每一步对目前构造的部分分解做一个拓展,直到获得问题的完整解为止,而算法的核心思想就在于,算法的每一步都必须满足以下条件:可行(满足问题的约束条件)、局部最优(当前步骤所有可行选择中的局部最优解)、不可取消(一旦选择,在后续步骤中不可改变)。
- 贪婪算法在求解最小生成树中的应用--Prim算法、Kruskal算法
- 贪婪算法在求解最短路径中的应用--Dijkstra算法
- 贪婪算法在解决哈夫曼树及编码问题中的应用
一、贪婪算法在求解最小生成树中的应用--Prim算法、Kruskal算法
感兴趣的读者可以先参考图论算法(四)--最小生成树的Kruskal [ 加边 ] 、Prim [ 加点 ] 的解法(JAVA)这篇文章
对于连通图来说生成树定义为包含图中所有顶点的连通无环子图
而在加权连通图中权重最小的生成树被称为最小生成树
1. Prim算法被又称为“加点法”,我们从图中的顶点集合中任意选择一个顶点作为序列的初始子树,每次迭代的时候,以贪婪的方式扩张生成树,该算法每次只扩展一个点,迭代的总次数为n-1。所以这就要求对于每个不在树中的顶点,必须知道它连接树中顶点的最短边信息。我们可以给一个顶点附加两个标记:树中最近顶点的名称以及对应边的长度。对于任意加入生成树中的顶点来说,我们要做两步,操作一:将该顶点从集合V-Vt 移动带顶点集合Vt中,操作二:对V-Vt中的每个顶点更新。
我们以下面这个图为例子讲解Prim算法的过程:
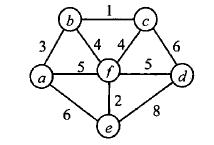
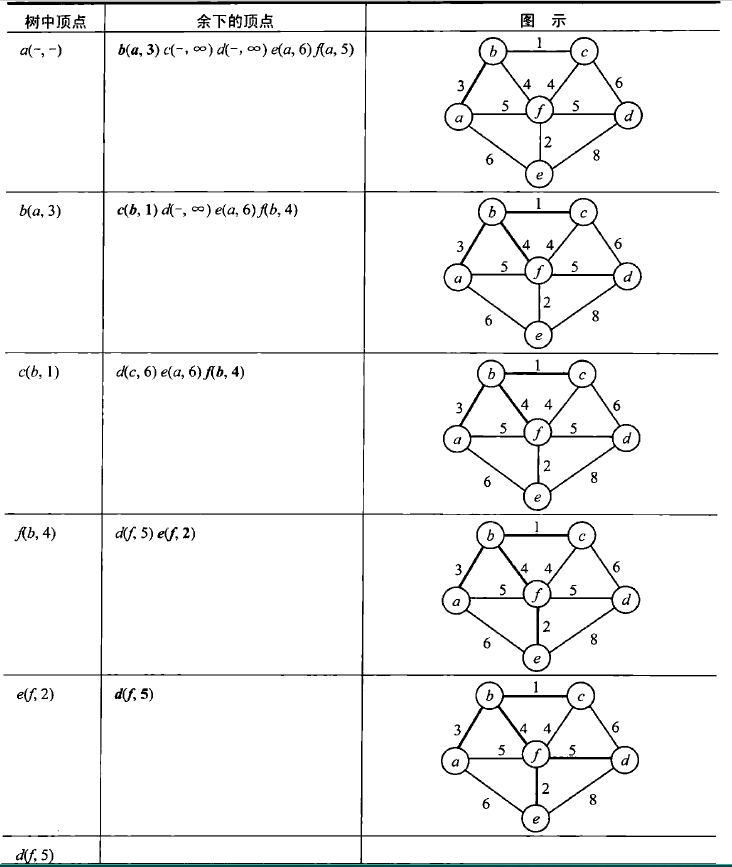
Input:
6 10 1 2 3 1 5 6 1 6 5 2 6 5 2 3 1 3 6 4 3 4 6 4 6 5 4 5 8
5 6 2
Output:
15
完整代码如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
import java.util.Scanner;
public class Main {
static int[][] e = new int[7][7];
static int[] book = new int[7];
static int[] dis = new int[7];
static int count = 0;
static int sum = 0;
static int n, m;
static int min, mark;
static Scanner input = new Scanner(System.in);
public static void main(String[] args) {
n = input.nextInt();
m = input.nextInt();
for (int i = 1; i <= n; i++) {
for (int j = 1; j <= n; j++) {
if (i == j) {
e[i][j] = 0;
} else {
e[i][j] = 99999999;
}
}
}
for (int i = 1; i <= m; i++) {
int a = input.nextInt();
int b = input.nextInt();
int c = input.nextInt();
e[a][b] = c;
e[b][a] = c;
}
for (int i = 1; i <= n; i++) {
dis[i] = e[1][i];
}
book[1] = 1;
prime();
System.out.println(sum);
}
private static void prim() {
count++;
while (count < n) {
min = 99999999;
for (int i = 1; i <= n; i++) {
if (book[i] == 0 && dis[i] < min) {
min = dis[i];
mark = i;
}
}
book[mark] = 1;
count++;
sum += dis[mark];
for (int i = 1; i <= n; i++) {
if (book[i] == 0 && dis[i] > e[mark][i]) {
dis[i] = e[mark][i];
}
}
}
}
}
时间复杂度O(n^2),如果采用堆来构造一个优先队列则会使算法的时间复杂度变为O(nlogn)
2. Kruskal算法又被称为“加边法”,这种算法会将加权连通图的最小生成树看成具有V-1条边的无环子图,且边的权重和最小。算法开始时,会按照权重的非递减顺序对图中的边排序,之后迭代的以贪婪的方式添加边。
下面以下图为例来讲解Kruskal算法的过程:
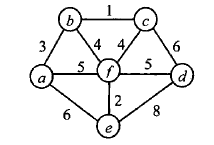
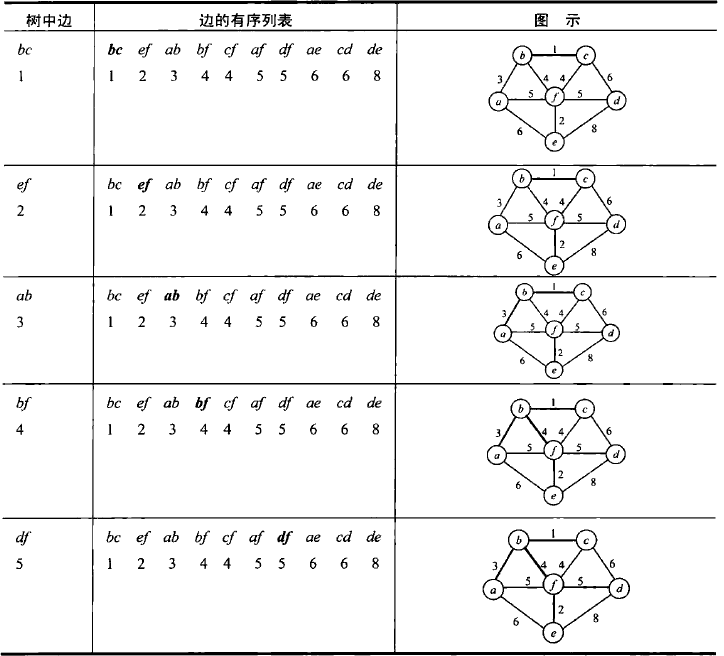
Input:
6 10 1 2 3 1 5 6 1 6 5 2 6 5 2 3 1 3 6 4 3 4 6 4 6 5 4 5 8
5 6 2
Output:
15
完整代码如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
import java.util.Scanner;
class edge {
int u, v, w;
edge(int u, int v, int w) {
this.u = u;
this.v = v;
this.w = w;
}
}
public class Main {
static edge[] e = new edge[11];
static int n, m;
static int[] f = new int[7];
static int sum = 0;
static int count = 0;
static Scanner input = new Scanner(System.in);
public static void main(String[] args) {
n = input.nextInt();
m = input.nextInt();
for (int i = 1; i <= m; i++) {
int a = input.nextInt();
int b = input.nextInt();
int c = input.nextInt();
e[i] = new edge(a, b, c);
}
/**
* 按权值排序
* */
quicksort(e, 1, m);
for (int i = 1; i <= n; i++) {
f[i] = i;
}
kruskal();
System.out.println(sum);
}
private static void kruskal() {
/**
* 从小到大枚举每一条边
* */
for (int i = 1; i <= m; i++) {
/**
* 检查一条边的两个顶点是否已经连通,即判断是否在同一个集合中
* */
if (merge(e[i].u, e[i].v)) {
count++;
sum = sum + e[i].w;
}
/**
* 选到n-1边之后,退出循环
* */
if (count == n - 1) {
break;
}
}
}
public static int partition(edge[] a, int p, int q) {
int x = a[p].w;
int i = p;
for (int j = p+1; j <= q; j++) {
if (a[j].w <= x) {
i += 1;
edge temp = a[i];
a[i] = a[j];
a[j] = temp;
}
}
edge temp = a[p];
a[p] = a[i];
a[i] = temp;
return i;
}
public static void quicksort(edge[] a,int p, int q) {
if (p < q) {
int r = partition(a ,p ,q);
quicksort(a, p, r - 1);
quicksort(a, r + 1, q);
}
}
private static int getf(int v) {
if (f[v] == v) {
return v;
} else {
/**
* 压缩路径,每次函数返回时,将该位置的编号转成祖宗编号
* */
f[v] = getf(f[v]);
return f[v];
}
}
private static boolean merge(int v, int u) {
int t1 = getf(v);
int t2 = getf(u);
/**
* 判断祖先是否相同
* */
if (t1 != t2) {
/**
* 靠左原则
* */
f[t2] = t1;
return true;
}
return false;
}
}
Kruskal算法的时间复杂度主要取决于对图中的边进行权值排序,如果排序算法效率比较高,那么Kruskal算法的时间复杂度为O(nlogn)
二、贪婪算法在求解最短路径中的应用--Dijkstra算法
最短路径问题最经典的算法就是Dijkstra算法,虽然不如Floyd算法能够求全源的最短路径,但是在效率上明显强于Floyd算法。
想了解Floyd算法的读者可以参考深入浅出讲算法思想--动态规划思想分析及应用
单源最短路径问题是对于加权连通图来说,我们给定一个起点,求出它到其他顶点之间的一系列最短路径。这个问题不同于从一个起点出发访问其他所有顶点的问题(TSP问题),这种问题所求的一组路径都是从起点出发通向图中的一个不同顶点。这些路径中可能存在公共边。
Dijkstra算法和Prim算法的用法比较相似,二者都是从顶点集中选择一个顶点来构造树,但是解决的问题是不同的。Dijkstra算法每次比较的是路径的总长度,每次要把权重相加。而Prim算法则直接比较权重。
以下图的例子来描述Dijkstra算法的过程:
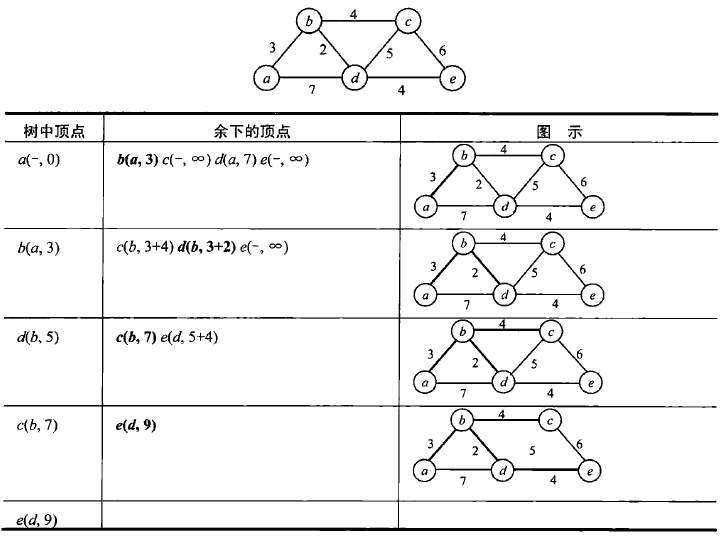
Input:
5 7 1 2 3 1 4 7 2 4 2 2 3 4 3 4 5 3 5 6 4 5 4
Output:
0 3 7 5 9
完整代码如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
import java.util.Scanner;
public class Main {
static int[][] e = new int[10][10];
static int[] book = new int[10];
static int[] dis = new int[10];
static int n, m;
static int min = 99999999;
static int mark = 0;
static Scanner input = new Scanner(System.in);
public static void main(String[] args) {
n = input.nextInt();
m = input.nextInt();
for (int i = 1; i <= n; i++) {
for (int j = 1; j <= n; j++) {
if (i == j) {
e[i][j] = 0;
} else {
e[i][j] = 99999999;
}
}
}
for (int i = 1; i <= m; i++) {
int a = input.nextInt();
int b = input.nextInt();
int c = input.nextInt();
e[a][b] = c;
e[b][a] = c;
}
/**
* 1到其他各点的距离
* */
for (int i = 1; i <= n; i++) {
dis[i] = e[1][i];
}
book[1] = 1;
dijkstra();
for (int i = 1; i <= n; i++) {
System.out.print(dis[i] + " ");
}
}
public static void dijkstra() {
/**
* 遍历n-1次,每次找出一个 1到某个点的最短距离
* */
for (int i = 1; i <= n-1; i++) {
min = 99999999;
/**
* 选出离1号点最近的顶点
* */
for (int j = 1; j <= n; j++) {
if (book[j] == 0 && dis[j] < min) {
min = dis[j];
mark = j;
}
}
book[mark] = 1;
/**
* 松弛
* */
for (int j = 1; j <= n; j++) {
if (e[mark][j] < 99999999) {
if (dis[j] > dis[mark] + e[mark][j]) {
dis[j] = dis[mark] + e[mark][j];
}
}
}
}
}
}
时间复杂度:O(nlogn),当然如果能够采用邻接表存储数据会更快。
三、贪婪算法在解决哈夫曼树及编码问题中的应用
哈夫曼编码,是一种可变字长编码(VLC)的高效算法。该算法是Huffman于1952年提出一种编码方法,该方法完全依据字符出现概率来构造异字头的平均长度最短的码字,有时称之为最佳编码。
相比定长编码来说,这种编码实现的压缩率(衡量压缩算法效率的重要指标)非常高,也就是说,哈夫曼编码比定长编码占用更少的存储空间。
假设我们要对某个字母表创建一套二进制前缀码,那么我们一般都会讲字母表中的字符与二进制的叶子联系起来,树中所有的左向边都为0,右向边都为1.可以通过记录根到字符叶子的简单路径上的标记来获得一个字符的代码字。这样任何一棵这样的树都可以生成一套前缀码。但是我们都知道即使在英文单词中,每个字母出现的概率都是不同的,如果仅仅是放到二叉树中,对于一些高频字符很可能需要更长的代码串来表示,这是非常不友好的。
一个方法就是通过根据字符出现的概率,尽可能将短位串分配给高频字符,长位串分配给低频字符。这里就用到了贪婪思想。
思路:
-
初始化n个单节点的数,表上字母表中的字符,并将其概率记录,用来表示权重。
-
找出两颗权重最小的树(对于权重都相同的树,任选其一),将它们作为新树中的左右子树,并将权值之和记录到新的树根中。迭代这一步操作,直到剩下一棵单独的树。
以下面的例子来描述哈夫曼树的构造过程:
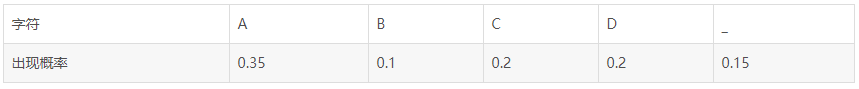
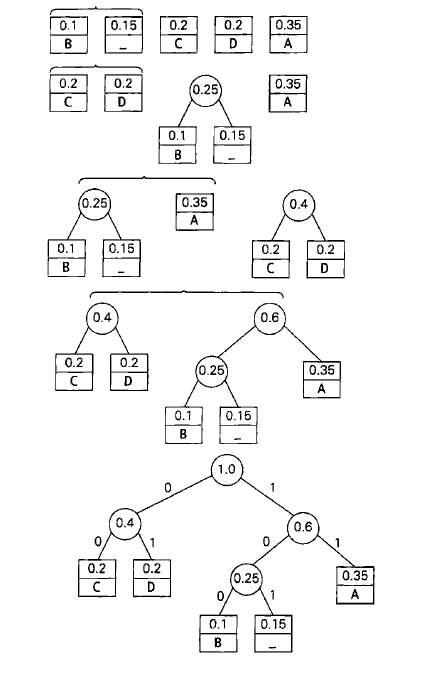
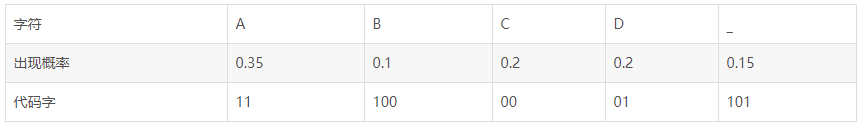
由上面的过程我们得到了下面的代码字:
Input:
5
A B C D _
35 10 20 20 15
Output:
A : 11
B : 100
C : 00
D : 01
_ : 101
完整代码如下:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
165
166
167
168
169
170
171
172
173
174
175
176
177
178
179
180
181
182
183
184
185
186
187
188
189
190
191
192
193
194
195
196
197
198
199
200
201
202
203
204
205
206
207
208
209
210
211
212
213
214
215
216
217
218
219
220
221
222
223
224
225
226
227
228
229
230
231
232
233
234
235
236
237
238
239
240
241
242
243
244
245
246
247
248
249
250
251
252
253
254
import java.util.Scanner;
public class Main {
//建立数的节点类
static class Node{
int weight;//频数
int parent;
int leftChild;
int rightChild;
public Node(int weight, int parent, int leftChild, int rightChild){
this.weight = weight;
this.parent = parent;
this.leftChild = leftChild;
this.rightChild = rightChild;
}
void setWeight(int weight){
this.weight = weight;
}
void setParent(int parent){
this.parent = parent;
}
void setLeftChild(int leftChild){
this.leftChild = leftChild;
}
void setRightChild(int rightChild){
this.rightChild = rightChild;
}
int getWeight(){
return weight;
}
int getParent(){
return parent;
}
int getLeftChild(){
return leftChild;
}
int getRightChild(){
return rightChild;
}
}
//新建哈夫曼编码
static class NodeCode {
String character;
String code;
NodeCode(String character, String code) {
this.character = character;
this.code = code;
}
NodeCode(String code) {
this.code = code;
}
void setCharacter(String character) {
this.character = character;
}
void setCode(String code) {
this.code = code;
}
String getCharacter() {
return character;
}
String getCode() {
return code;
}
}
//初始化一个哈弗曼树
public static void initHuffmanTree(Node[] huffmanTree, int m){
for(int i = 0; i < m; i++){
huffmanTree[i] = new Node(0, -1, -1, -1);
}
}
//初始化编码
public static void initHuffmanCode(NodeCode[] huffmanCode, int n){
for(int i = 0; i < n; i++){
huffmanCode[i] = new NodeCode("","");
}
}
//获取huffmanCode的符号
public static void getHuffmanCode(NodeCode[] huffmanCode, int n){
Scanner input = new Scanner(System.in);
for(int i = 0; i < n; i++){
String temp = input.next();
huffmanCode[i] = new NodeCode(temp,"");
}
}
//获取频率
public static void getHuffmanWeight(Node[] huffmanTree , int n){
Scanner input = new Scanner(System.in);
for(int i = 0; i < n;i ++){
int temp = input.nextInt();
huffmanTree[i] = new Node(temp, -1, -1, -1);
}
}
//选取两个较小的结点
public static int[] selectMin(Node[] huffmanTree ,int n) {
int min[] = new int[2];
class TempNode {
int newWeight;//存储权
int place;//存储该结点所在的位置
TempNode(int newWeight, int place){
this.newWeight = newWeight;
this.place = place;
}
void setNewWeight(int newWeight){
this.newWeight = newWeight;
}
void setPlace(int place){
this.place = place;
}
int getNewWeight(){
return newWeight;
}
int getPlace(){
return place;
}
}
TempNode[] tempTree = new TempNode[n];
//将huffmanTree中没有双亲的结点存储到tempTree中
int i=0,j=0;
for(i = 0; i < n; i++) {
if(huffmanTree[i].getParent() == -1 && huffmanTree[i].getWeight()!=0) {
tempTree[j] = new TempNode(huffmanTree[i].getWeight(),i);
j++;
}
}
int m1,m2;
m1 = m2 = 0;
for(i = 0; i < j; i++) {
if(tempTree[i].getNewWeight() < tempTree[m1].getNewWeight())//此处不让取到相等,是因为结点中有相同权值的时候,m1取最前的
m1 = i;
}
for(i = 0; i < j; i++) {
if(m1 == m2)
m2++;//当m1在第一个位置的时候,m2向后移一位
if(tempTree[i].getNewWeight() <= tempTree[m2].getNewWeight() && i != m1)//此处取到相等,是让在结点中有相同的权值的时候,
//m2取最后的那个。
m2 = i;
}
min[0] = tempTree[m1].getPlace();
min[1] = tempTree[m2].getPlace();
return min;
}
//创建哈弗曼树
public static void createHaffmanTree(Node[] huffmanTree,int n){
if(n <= 1)
System.out.println("Parameter Error!");
int m = 2 * n - 1;
//initHuffmanTree(huffmanTree,m);
for(int i = n; i < m; i++) {
int[] min = selectMin(huffmanTree, i);
int min1 = min[0];
int min2 = min[1];
huffmanTree[min1].setParent(i);
huffmanTree[min2].setParent(i);
huffmanTree[i].setLeftChild(min1);
huffmanTree[i].setRightChild(min2);
huffmanTree[i].setWeight(huffmanTree[min1].getWeight() + huffmanTree[min2].getWeight());
}
}
//创建哈夫曼编码
public static void createHaffmanCode(Node[] huffmanTree,NodeCode[] huffmanCode,int n){
Scanner input = new Scanner(System.in);
char[] code = new char[10];
int start;
int c;
int parent;
int temp;
code[n-1] = '0';
for(int i = 0; i < n; i++)
{
StringBuffer stringBuffer = new StringBuffer();
start = n-1;
c = i;
while((parent=huffmanTree[c].getParent()) >= 0)
{
start--;
code[start] = ((huffmanTree[parent].getLeftChild() == c) ? '0' : '1');
c = parent;
}
for(;start < n-1; start++){
stringBuffer.append(code[start]);
}
huffmanCode[i].setCode(stringBuffer.toString());
}
}
//输出
public static void ouputHaffmanCode(NodeCode[] huffmanCode,int n){
for(int i = 0; i < n; i++){
System.out.println(huffmanCode[i].getCharacter() + " : " + huffmanCode[i].getCode());
}
}
//主函数
public static void main(String[] args){
Scanner input = new Scanner(System.in);
int n;
int m;
n = input.nextInt();
m = 2*n-1;
Node[] huffmanTree = new Node[m];
NodeCode[] huffmanCode = new NodeCode[n];
//初始化
initHuffmanTree(huffmanTree, m);
initHuffmanCode(huffmanCode, n);
//获取符号
getHuffmanCode(huffmanCode, n);
//获取概率
getHuffmanWeight(huffmanTree, n);
//创建哈夫曼树
createHaffmanTree(huffmanTree, n);
//创建哈夫曼编码
createHaffmanCode(huffmanTree, huffmanCode, n);
//输出
ouputHaffmanCode(huffmanCode, n);
}
}
注意:输出哈夫曼树和输出哈夫曼编码时不同的操作。